Gobble up pudding

プログラミングの記事がメインのブログです。

MENU

KVM qcow2 スナップショットと性能劣化の話

Ubuntu + KVM 環境でスナップショットを取った後、削除しても性能が戻らない問題と、その仕組み・対処法のまとめ。


1. スナップショットの種類

KVM/libvirt のスナップショットには大きく2種類ある。

種類 仕組み Cockpit からの作成
Internal .qcow2 ファイル内部にスナップショットデータを埋め込む ✅ デフォルト(種類を選ぶ UI なし)
External 元ファイルを read-only にし、差分を別の qcow2 オーバーレイに書き込む ❌ Cockpit 不可(virsh が必要)

Cockpit 経由で取られたスナップショットは 基本的に internal と考えてよい。裏で virsh snapshot-create-as のデフォルト動作(internal)が走っている。


2. なぜスナップショット削除後も遅いままなのか

これが本題。直感的には「使っていない領域が残っているだけ」に思えるが、実際にはちゃんと性能に影響する理由がある。

2.1 ファイルサイズが縮まない

internal スナップショットを virsh snapshot-deleteqemu-img snapshot -d で消しても、qcow2 はクラスタを「未使用」とマークするだけで、ファイルシステムには領域を返さない。

QEMU 開発者の公式回答(libvirt-users ML): "QEMU will just mark the clusters as unused, it won't return them to the underlying filesystem."

つまり メタデータ上は消えていても、物理的なファイルサイズは肥大化したまま

2.2 L2 キャッシュがカバーしきれなくなる

qcow2 は「仮想ディスク上のオフセット → ファイル内の物理オフセット」を引くために L1/L2 テーブルというインデックス構造を持つ。

QEMU はこの L2 テーブルを RAM 上にキャッシュしているが、デフォルトの L2 キャッシュサイズは 1MB で、これは仮想ディスク 8GB ぶんしかカバーできない(Alberto García / Igalia による解説)。

ファイルが肥大化
    ↓
必要な L2 メタデータが増える
    ↓
キャッシュに収まらない部分が出る
    ↓
ディスクから L2 を毎回読み直し
    ↓
I/O レイテンシが増える

2.3 refcount-block のチェックコスト

qcow2 は破損検出のため書き込み時に複数のサニティチェックを行う。中でも refcount-block チェックは qcow2 ファイルの実サイズに比例してコストが増える(小さなイメージでも比較的高コスト)。

これも「ファイルが大きいほど遅くなる」要因のひとつ。

2.4 ホスト側のファイルシステム断片化

qcow2 ファイル自体が大きくなれば、ホストのファイルシステム上で断片化が進みやすくなる。シーケンシャルに見える読み取りが、実際は物理的にバラバラの場所を辿っていることになる。

2.5 ページキャッシュの圧迫

ホストの RAM 上のページキャッシュに qcow2 全体が乗らなくなる → キャッシュミスが増える → 実ディスクアクセスが増える。


3. DB の dead tuple 問題とのアナロジー

この現象は PostgreSQL などの DB で起きる「論理削除と物理解放のズレ」と構造的に同じ。

DB(PostgreSQL等) KVM/qcow2
テーブルの dead tuple qcow2 の未解放クラスタ
インデックスの肥大化 L1/L2 テーブルの肥大化
VACUUM virt-sparsify
REINDEX / pg_dump+restore qemu-img convert
autovacuum TRIM/UNMAP の自動解放

共通する本質:

「論理的に空き」と「物理的に解放済み」が
自動的には一致しない
    ↓
管理メタデータが肥大化したまま残る
    ↓
検索・参照のたびにそのコストを払い続ける

4. 解消方法

4.1 推奨手順(セットで実施)

# 1. VM を停止
virsh shutdown <domain>

# 2. 念のためバックアップ
cp /var/lib/libvirt/images/vm.qcow2 /backup/vm.qcow2.bak

# 3. 残っているスナップショットを確認
qemu-img snapshot -l /var/lib/libvirt/images/vm.qcow2

# 4. スナップショットを削除(メタデータレベル)
qemu-img snapshot -d <snapshot_name> /var/lib/libvirt/images/vm.qcow2

# 5. qemu-img convert で新クリーンイメージに変換(ここで物理的に縮む)
qemu-img convert -O qcow2 vm.qcow2 vm-new.qcow2

# 6. 差し替え
mv vm-new.qcow2 vm.qcow2

# 7. オーナー・パーミッションを戻す(必要に応じて)
chown libvirt-qemu:kvm vm.qcow2
chmod 600 vm.qcow2

4.2 なぜ「セット」なのか

  • qemu-img snapshot -d だけ → メタデータは消えるが物理ブロックは残る
  • qemu-img convert だけ → スナップショットも含めて全部コピーされるので残ってしまう

両方やって初めて完全にクリーンになる。

4.3 補助的な手段

  • virt-sparsify ── ゲスト内の空き領域(ゼロブロック)をホストに返す。VMware のゼロフィル+shrink と本質的に同じ。
  • TRIM/UNMAP 対応 ── libvirt XML で discard='unmap' を設定し、ゲストから発行された TRIM をホスト側で qcow2 のクラスタ解放に反映させる(最近の環境向け)。

5. 運用のベストプラクティス

① 作業前にスナップショット取得
        ↓
② 検証・作業・必要ならロールバック
        ↓
③ 「これで確定」となったらスナップショット削除
        ↓
④ qemu-img convert で新クリーンイメージに変換
        ↓
⑤ 差し替えて運用再開

DB で言えば「作業ブランチでやって、確定したら pg_dump & restore でクリーンにする」のと同じ感覚。

注意点

  • qemu-img convert 中は VM を停止する必要がある
  • イメージサイズによっては時間がかかる(数十 GB で数十分)
  • 変換後しばらくは元ファイルをバックアップとして残しておくと安全
  • スナップショットチェーンを 2〜3 個以上残さないのが定石

6. 参考リンク

理論・メカニズム

実用的影響

公式回答(QEMU 開発者)

実例・症例

手順


TL;DR

  • Cockpit で取るスナップショットは internal(qcow2 ファイル内埋め込み)
  • 削除してもクラスタは「未使用」マークされるだけで物理的には残る
  • ファイルが肥大化すると L2 メタデータがキャッシュに収まらず性能が落ちる
  • 完全に元に戻すには スナップショット削除 + qemu-img convertセットでの実施が必要
  • 構造的には DB の dead tuple / インデックス肥大化と同じ問題

GitHubのコミット履歴から個人のメールアドレスを消す

背景

GitHubのコミット履歴にはメールアドレスが埋め込まれており、誰でも確認できる。スパム対策として、過去のコミット履歴を書き換えつつ、今後のコミットにはno-replyアドレスを使うようにした。
ちなみに2014年くらい前からGitHubでno-replyのアドレスが設定できるようになった。

やりたいこと

  • emailアドレスをGitHubのno-replyアドレスに変更
  • GitHubの名前を途中で変えてるのでそれも変えたい(今回はそのスクリプトはないけど、--name-callbackで条件書けばできる)。

方針

  • 今後のコミット → GitHubのno-replyアドレスに変更
  • 過去のコミット → git-filter-repo で一括書き換え
  • プロフィールのメールアドレス → Settings → Emails → "Keep my email addresses private" をオン

no-replyアドレスの確認

GitHub Settings → Emails に表示されている以下の形式のアドレスを使う。

12345678+username@users.noreply.github.com

今後のコミットに使うよう設定:

git config --global user.email "12345678+username@users.noreply.github.com"

systemレベルも変えておく(管理者権限が必要): 基本systemレベルでは設定しないため消しておく

git config --system --unset user.email

確認

git config --global user.email  # 新しいものに変わっていればOK
git config --system user.email  # 何も出ない

プロジェクト単位でe-mail設定しているものがあるか探すシェル

通常ないと思うがメールアドレスを使い分けている場合にあり得る

Mac/Linux/WSL:

find ~ -path "*/.git/config" -exec grep -H "email" {} \;

Windows:

Get-ChildItem -Path $HOME -Recurse -Force -Filter "config" -ErrorAction SilentlyContinue |
  Where-Object { $_.DirectoryName -like "*\.git" } |
  Select-String "email" |
  Select-Object Path, Line

※Git Bashでやってもいいが、遅いのでPowerShellを推奨。PowerShellは便利なんだけど、記述が長すぎて嫌いだけれども(エイリアスを使うのは非推奨みたいだし)。


git-filter-repo のインストール

※Pythonが入っている必要があります。

pip install git-filter-repo

GitHub CLI のインストール

リポジトリ一覧の取得に使う。

Mac:

brew install gh

Windows:

winget install GitHub.cli

Linux/WSL:

curl -fsSL https://cli.github.com/packages/githubcli-archive-keyring.gpg | sudo dd of=/usr/share/keyrings/githubcli-archive-keyring.gpg
echo "deb [arch=$(dpkg --print-architecture) signed-by=/usr/share/keyrings/githubcli-archive-keyring.gpg] https://cli.github.com/packages stable main" | sudo tee /etc/apt/sources.list.d/github-cli.list > /dev/null
sudo apt update && sudo apt install gh

インストール後に認証:

gh auth login

一括書き換えスクリプト

公開リポジトリだけに制限しています。
注意事項:テストしてから実行してください。責任は負えません。 自分の場合、完全に自分のリポジトリだけだと思ったら、
忘れているのがあって、callbackで条件文を入れず、フォークリポジトリで他の人のユーザ名をかきかえてしまい…
reflogから戻しました。

以下のは書き換えた後force pushまで行います。

gh repo list $GH_USER --visibility=public --json name --jq '.[].name'

以下

OLD_EMAIL="12345678@example.com"
OLD_USER="username"
NEW_EMAIL="12345678+username@users.noreply.github.com"
GH_USER="username"

を書きかえてください。 なおHTTPSでリモートのURLを書き換えているのでSSHの場合は適宜書き換えてください。 名前を変えてない限りはOLD_USERはGH_USERと一緒でいいです。

Bash版(Mac/WSL/Linux)

#!/bin/bash
OLD_EMAIL="12345678@example.com"
OLD_USER="username"
NEW_EMAIL="12345678+username@users.noreply.github.com"
GH_USER="username"

REPOS=($(gh repo list $GH_USER --visibility=public --json name --jq '.[].name'))

for REPO in "${REPOS[@]}"; do
    echo "Processing $REPO..."
    git clone "https://github.com/$GH_USER/$REPO.git" "tmp-$REPO"
    cd "tmp-$REPO"
    git filter-repo --name-callback "return b'$GH_USER' if name == b'$OLD_NAME' else name" --email-callback "return b'$NEW_EMAIL' if email == b'$OLD_EMAIL' else email"
    if [ $? -ne 0 ]; then
        echo "SKIP: $REPO のfilter-repoに失敗しました"
        cd ..
        rm -rf "tmp-$REPO"
        continue
    fi
    git remote add origin "https://github.com/$GH_USER/$REPO.git"
    git push --force --all
    if [ $? -ne 0 ]; then
        echo "SKIP: $REPO のpushに失敗しました(protected branch?)"
        cd ..
        rm -rf "tmp-$REPO"
        continue
    fi
    git push --force --tags
    cd ..
    rm -rf "tmp-$REPO"
done

PowerShell版(Windows)

PowerShellのスクリプト実行ポリシーをセッション限りで緩和しておく(管理者権限不要):

Set-ExecutionPolicy -Scope Process RemoteSigned

スクリプト本体:

$OLD_EMAIL="12345678@example.com"
$OLD_USER="username"
$NEW_EMAIL = "12345678+username@users.noreply.github.com"
$GH_USER = "username"

$REPOS = gh repo list $GH_USER --visibility=public --json name --jq '.[].name'

foreach ($REPO in $REPOS) {
    Write-Host "Processing $REPO..."
    git clone "https://github.com/$GH_USER/$REPO.git" "tmp-$REPO"
    Set-Location "tmp-$REPO"
    git filter-repo --name-callback "return b'$GH_USER' if name == b'$OLD_NAME' else name" --email-callback "return b'$NEW_EMAIL' if email == b'$OLD_EMAIL' else email"
    if ($LASTEXITCODE -ne 0) {
        Write-Host "SKIP: $REPO のfilter-repoに失敗しました"
        Set-Location ..
        Remove-Item -Recurse -Force "tmp-$REPO"
        continue
    }
    git remote add origin "https://github.com/$GH_USER/$REPO.git"
    git push --force --all
    if ($LASTEXITCODE -ne 0) {
        Write-Host "SKIP: $REPO のpushに失敗しました(protected branch?)"
        Set-Location ..
        Remove-Item -Recurse -Force "tmp-$REPO"
        continue
    }
    git push --force --tags
    Set-Location ..
    Remove-Item -Recurse -Force "tmp-$REPO"
}

注意点

  • git filter-repo はclone時のoriginを意図的に削除する(誤push防止のため)。そのため git remote add origin が必要
  • コミットのhashは変わるが、AuthorDate/CommitDateは変わらない
  • forkされたリポジトリには変更が反映されない(fork側の歴史はそのまま残る)
  • ローカルの既存cloneはforce push後に git pull できなくなるため、再cloneが必要
  • protected branchがある場合はGitHub側でブランチ保護を一時的に外してからpushする
  • 手元で自分のケースではうまくいっているのを確認しているが、お試しのプロジェクトで一度うまくいくか確認して実行したほうが良いです。
  • 自分の手元のリポジトリはgit cloneし直すのが良いかと思います。

Claudeに課金してみたら、アプリ作成以外にもいろんな使い途があることが分かった

Claudeというとプログラミングのイメージ

ClaudeといえばClaude Codeというコマンドラインからのアプリ作成でこれがメインといえばそうなんだろうけど、
それ以外も充実していることがわかったので備忘録として残しておきます。

課金について

Claude.aiとClaude Codeは同じ使用枠を共有している

Claude.aiのチャットClaude Code(ターミナルのCLI)は、同じプランの使用枠を使っています。ターミナルでClaude Codeをがんがん使ったら、ブラウザ・アプリ経由のチャットでも使える量が減ります。逆も同じです。別々に課金されてるわけではないです。

プラン別の月額と使用量

プラン 月額 使用量の目安
Free 無料 1日40メッセージ程度
Pro $20/月 Freeの約5倍
Max 5x $100/月 Proの5倍
Max 20x $200/月 Proの20倍

おそらくまともに使うならPro以上の課金が必要です。 でも1日40メッセージなので、Chatだけなら無料枠でも結構いけるのではないか?という感覚があります。
ここでまずはアカウント登録する必要があり、その先から課金が選択できます。 しばらく使ってみての感想はClaude Codeをするなら課金必須です。ただProだとSonnetを中心に使い続けることになると思いますが、基本的にそれで問題はないでしょう。

  1. Claude公式サイト(https://claude.ai/)にアクセスする
  2. 登録画面でメールアドレスを入力し、「Continue with email(メールで続ける)」をクリックする

ゲームのランキングページ作成

ちょっとしたUIページ作成を全部お願いし、それを誰かに共有したいなーという感じで依頼をしました。
アカウント登録後にデスクトップアプリのダウンロードを促されるたので、とりあえずそれをダウンロード。

やりたかったこと

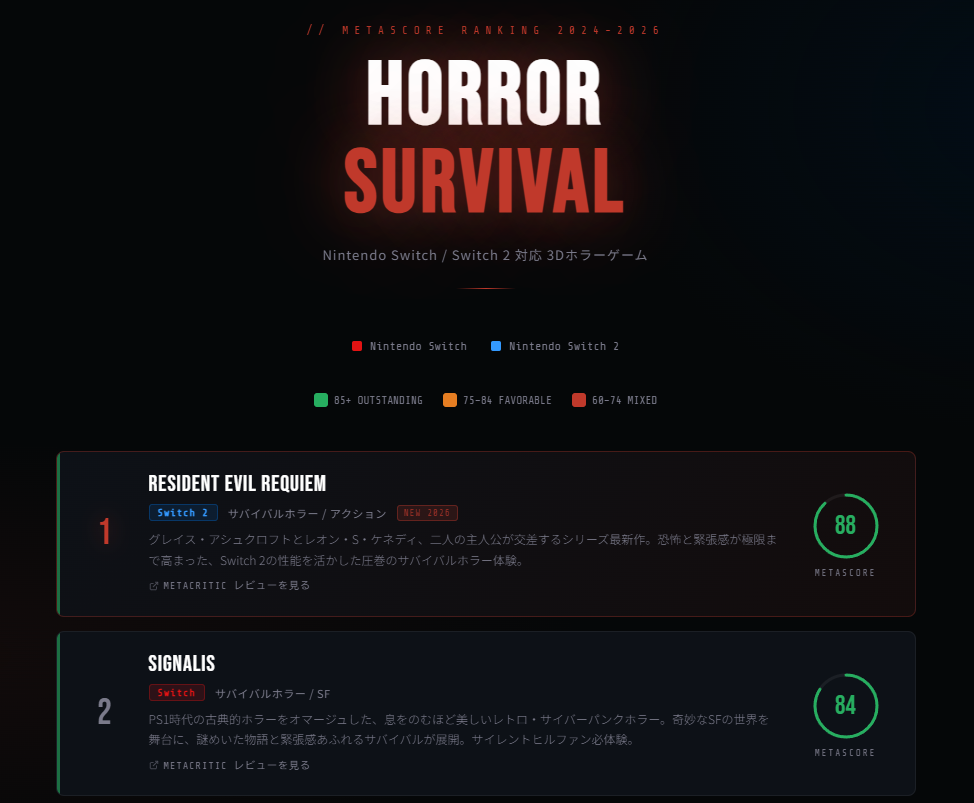
バイオハザード・サイレントヒルみたいな3Dホラーゲームが好きで、Switch / Switch 2 で遊べるやつをMetaScoreの高い順にまとめたリストが欲しかった。
スコアが視覚的にわかるグラフィカルなやつをHTMLでお願いしました。

Claude にお願いしたこと

最初のお願いはざっくりこんな感じ。

「バイオハザード、サイレントヒルみたいな3Dで遊べるゲームで、SwitchまたはSwitch2でMetaScoreの高い順におすすめのリストを作成してください。単なるランキングではなくスコアも付けて、レビューのリンク先も付与して、グラフィカルでわかりやすい形式にしてほしい」

何で作るかはHTMLを指定しました。

Metacritic を調べてスコアを収集

Claude はまず自分でWeb検索をかけて、Switch / Switch 2 で遊べるホラーゲームのMetaScoreを調べてくれた。最終的に集まったのはこんなラインナップでした。

ランク タイトル プラットフォーム MetaScore
1 Resident Evil Requiem Switch 2 88
2 SIGNALIS Switch 84
3 Alien: Isolation Switch 83
4 Resident Evil 4 HD Switch 80
5 Resident Evil HD Remaster Switch 80
6 RE Revelations Collection Switch 78
7 Resident Evil 7: Biohazard Switch (クラウド) 76
8 Layers of Fear: Legacy Switch 75
9 Outlast 1 & 2 Switch 74
10 Fatal Frame: Mask of the Lunar Eclipse Switch 73
11 Fatal Frame: Maiden of Black Water Switch 72

出来上がったHTML

ダークなデザインで、スコアがアニメーションで伸びる円グラフになってて、各カードをクリックするとMetacriticのレビューページに飛べるようになってました。Switch は赤バッジ、Switch 2 は青バッジで色分けされていた。ちゃんとレスポンシブになっててスマホで見ても問題なかったです。

スコアの色も「85以上:緑」「75〜84:オレンジ」「74以下:赤」と直感的に使い分けてくれてました。

共有どうする問題

HTMLファイルをそのままiPhoneで開こうとしたら、zip形式になってしまって読めない問題が発生ました。

Claude にどうすればいいか聞いたところ、3つの案を出してくれました。

  1. PNG画像に変換してLINEで送る
  2. PDFにする
  3. Webに公開してリンクを共有 pagedrop.io

3のpagedrop.ioを試し、秘匿情報は何もないのでWebにコピペでホスティング完了。 無料・匿名でできてらくちん。

まとめ

  • Web検索 → スコア収集 → デザイン → ファイル生成まで全部一貫してやってくれる
  • HTMLのデザインクオリティが思ったより高い(アニメーションとかも自分で考えてくれる)
  • 詰まったときに代替案をすぐ出してくれる

なお、このブログのドラフトもClaudeにやってもらいました。

期間の重複部分の合計を出す

期間の判定関連の話です。期間関連は定石がありまして、 例えば期間の重複判定は次のように開始と終了を互いにチェックする定石があります。

比較開始日付 <= 対象終了日付 AND 比較終了日付 >= 対象開始日付
※=が含まれるかどうかは要件によります

qiita.com

今回はそうでなくて、期間の重複部分の合計がテーマです。 例えば次のような例を考えたときにたまに、期間の重複部分の合計を出したいことがあります。

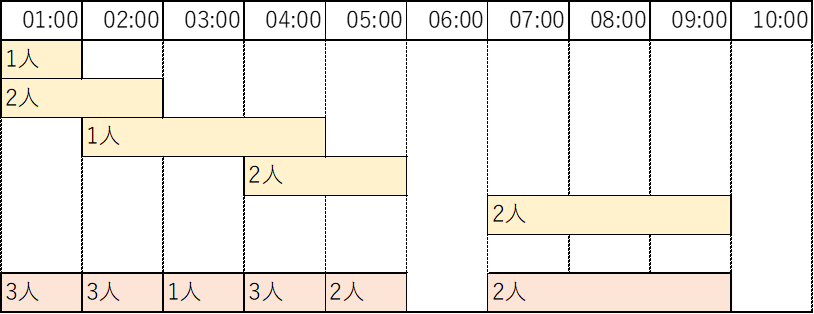
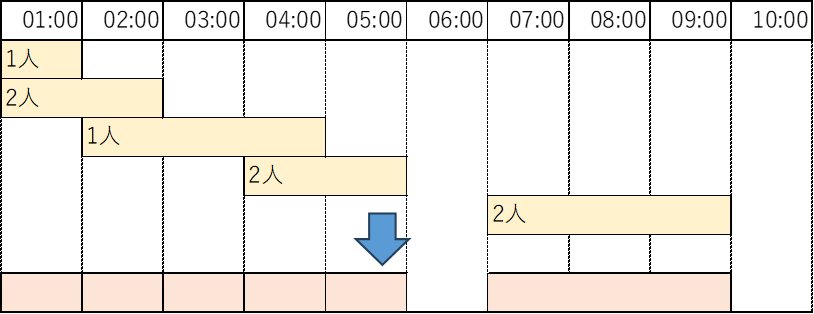
歯医者の例を考えてみよう。時間は昼(PM)と思ってもらって、
図中の人は歯医者に予約している患者の数だと思ってもらえればよいです。
その時の各時間の人数を知りたいことがあります。

ではこれをプログラミングによって求める場合
一例として次のようにできます。

まずこのように開始と終了のペアで期間に区切ってしまいます。
要は変化のあることで区切ります。ただ、もともと分割されている場合はそのままとします。
このとき、細かいことですが、
現在行の終了 <= 次の行の開始とは限らないので、ソートする必要があります。
また、開始=終了という行も発生するためそれを取り除く必要があります。
細かいところは後で載せているコードを見るとわかるかと思います。

その後、その期間に対して
各データ行が次の式で被っているかどうかを見て、被っていたら加算します

[各データ行.開始] <= 期間.from < [各データ行.終了]

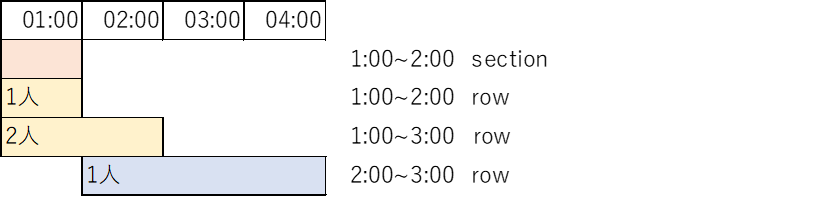
前提として 1:00~2:00と書いた場合、1時は含み、2時は含まないものとします。より具体的にいうと1:00~1:59みたいなイメージ 厳密に閉区間、開区間の記号であらわすと[1:00~2:00)です。

期間に区切った後、ループ処理で期間に対し次のような判定を行います。

row.from (1:00) <= section.from(1:00) < row.to(2:00)  条件を満たすので加算
row.from (1:00) <= section.from(1:00) < row.to(3:00)  条件を満たすので加算
row.from (2:00) <= section.from(1:00) < row.to(5:00)  条件を満たさない
…

このときsectionは必ず from < toで幅を持ち必ず被ることになるのでtoを見る必要はないです。
これらをプログラミングに直すと次のようになる。なおJavaScriptで記述しています。 時間を文字列で持つべきではないですが、例を簡単にするため便宜的に文字列にしています。

手抜きで文字列でソートしたいのもあるので1:00をプログラミング上では01:00と書いています。

// [from, to) from <= x < toの閉区間(含む)、開区間(含まない)とする
const data = [
    {from: "01:00", to: "02:00", number: 1},
    {from: "01:00", to: "03:00", number: 2},
    {from: "02:00", to: "05:00", number: 1},
    {from: "04:00", to: "06:00", number: 2},
    {from: "07:00", to: "10:00", number: 2},
];

// セクションにわける
function divideIntoSections(data) {
    const times = [];
    for (const row of data) {
        times.push(row.from);
        times.push(row.to);
    }
    // 昇順ソート
    const sorted = [...new Set(times)].sort();
    // 境界となる時間を作成する
    const sections = [];
    for (let i = 0; i < sorted.length - 1; i++) {
        sections.push({ from: sorted[i], to: sorted[i + 1] });
    }
    // from~toが同一のものは除外
    return sections.filter(s => s.from != s.to);
}

const sections = divideIntoSections(data);
for (const section of sections) {
    // セクションに期間が被っていれば加算
    section.number = 0;
    for (const row of data) {
        // =の条件に注意 特にrow.toのところ
        if (row.from <= section.from && section.from < row.to) {
            section.number += row.number;
        }
    }
}

// 0除外
const results = sections.filter(s => s.number !== 0);

for (const result of results) {
    console.log(`${result.from} ${result.to} ${result.number}`);
}

現実にはこれが、病院ごとにデータがあり、 それを病院ごとに集計みたいな感じになりますが、そのやり方については後日気が向いたら書きます。

ちなみに今回はこれをSQLで書けたらなぁと思い、トライしてみましたがSQL力が弱く断念しました。
LEADとLAGを使えばできそうなのですが、なんといってもデバッグしずらいのが悩みの種。
また、SQLは宣言的、もといDSLであるがゆえにこの手の処理はSQLでは逆に見通しが悪くなる気がしています。
あまり周りにこの意見に同意してくれる人がいないです。

これに近いことをやればできるはず。 qiita.com